01
Input
El proceso comienza con una descripción proporcionada por el usuario desde una interfaz diseñada para funcionar tanto en escritorio como en dispositivos móviles.
Proyecto
Servicio autoalojado de generación de imágenes construido alrededor de inferencia local y un pipeline automático que transforma una idea inicial en una petición preparada para el sistema de generación.
ai.vjml.es explora cómo ofrecer generación de imágenes mediante una interfaz sencilla manteniendo el procesamiento dentro de infraestructura controlada. El sistema automatiza la preparación de la petición antes de enviarla al backend local de inferencia, separando la experiencia de usuario de la complejidad del proceso de generación.
El proceso comienza con una descripción proporcionada por el usuario desde una interfaz diseñada para funcionar tanto en escritorio como en dispositivos móviles.
La petición se transforma automáticamente en una descripción estructurada y más adecuada para el proceso de generación, reduciendo la necesidad de construir prompts complejos manualmente.
El pipeline organiza y refina los elementos de la petición antes de construir la entrada final utilizada por el backend de generación.
La petición preparada se procesa mediante un backend de inferencia ejecutado en infraestructura propia y el resultado vuelve a la interfaz como imagen generada.
La misma experiencia de generación y exploración está disponible en escritorio y móvil, incluyendo información sobre cada imagen generada.
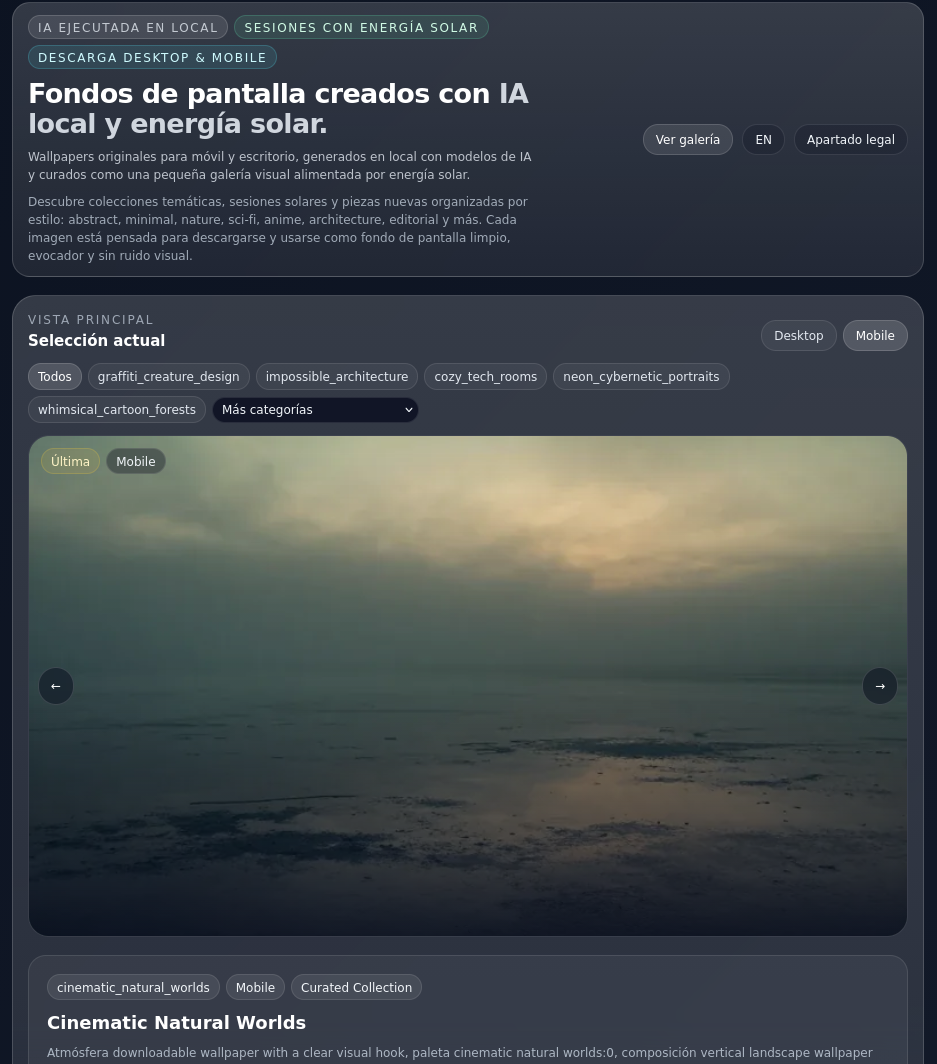
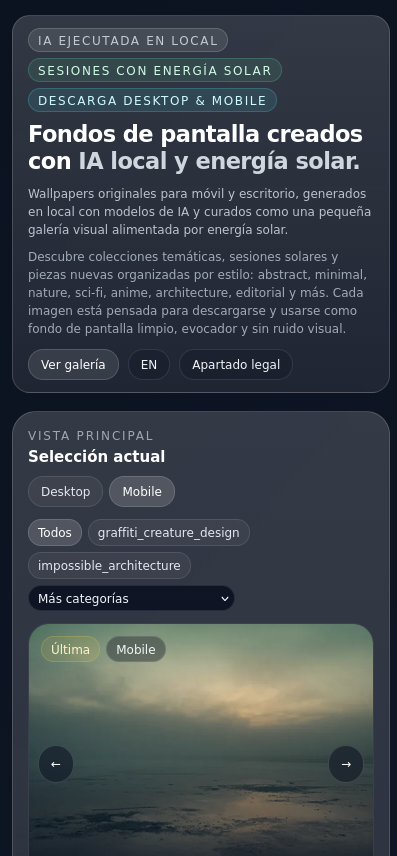
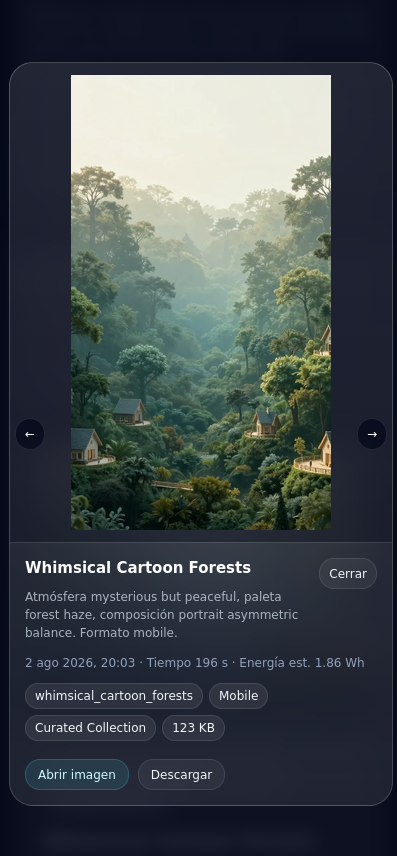
La aplicación separa la interfaz pública, la preparación de las peticiones y la inferencia para poder evolucionar cada parte del sistema de forma independiente.
Interfaz pública desde la que se crean las solicitudes y se presentan los resultados, adaptada a escritorio y móvil.
Capa encargada de interpretar la petición, estructurarla y construir automáticamente la entrada utilizada para generar la imagen.
El servicio coordina las peticiones de generación y mantiene desacoplada la aplicación web del proceso de inferencia.
La generación se ejecuta localmente sobre infraestructura controlada, sin exponer públicamente los detalles internos del backend.
La capa web y la carga de inferencia pueden ejecutarse en sistemas diferentes, permitiendo asignar cada tarea al nodo más apropiado.
La separación entre componentes permite experimentar y evolucionar el pipeline sin rediseñar la interfaz pública ni acoplarla a una implementación concreta de inferencia.
La versión actual del pipeline de prompts continúa en proceso de refinamiento para aprovechar mejor la información extraída de cada petición, mejorar la composición y aumentar la variación de los resultados manteniendo una entrada sencilla para el usuario.